從登入到生成,
一次學會 VoAI 聲音創造所
本教學帶你走過帳號登入、會員管理、10 大生成功能,到生成紀錄的完整流程。每個步驟均對照平台實際畫面與按鈕,跟著做就上手。
開始使用
- 1 · 登入與進入平台
- 2 · 介面導覽與會員管理
生成功能
- 3 · 角色總覽
- 4 · 短篇配音
- 5 · 長篇配音
- 6 · 音色複製
- 7 · 文字生成 Podcast
- 8 · 圖片生成 Podcast
- 9 · 音檔組合
- 10 · 虛擬人簡報
- 11 · 虛擬人影片
- 12 · 虛擬人圖片
生成後管理
- 13 · 生成後操作
- 14 · 生成紀錄
登入與進入平台 /login
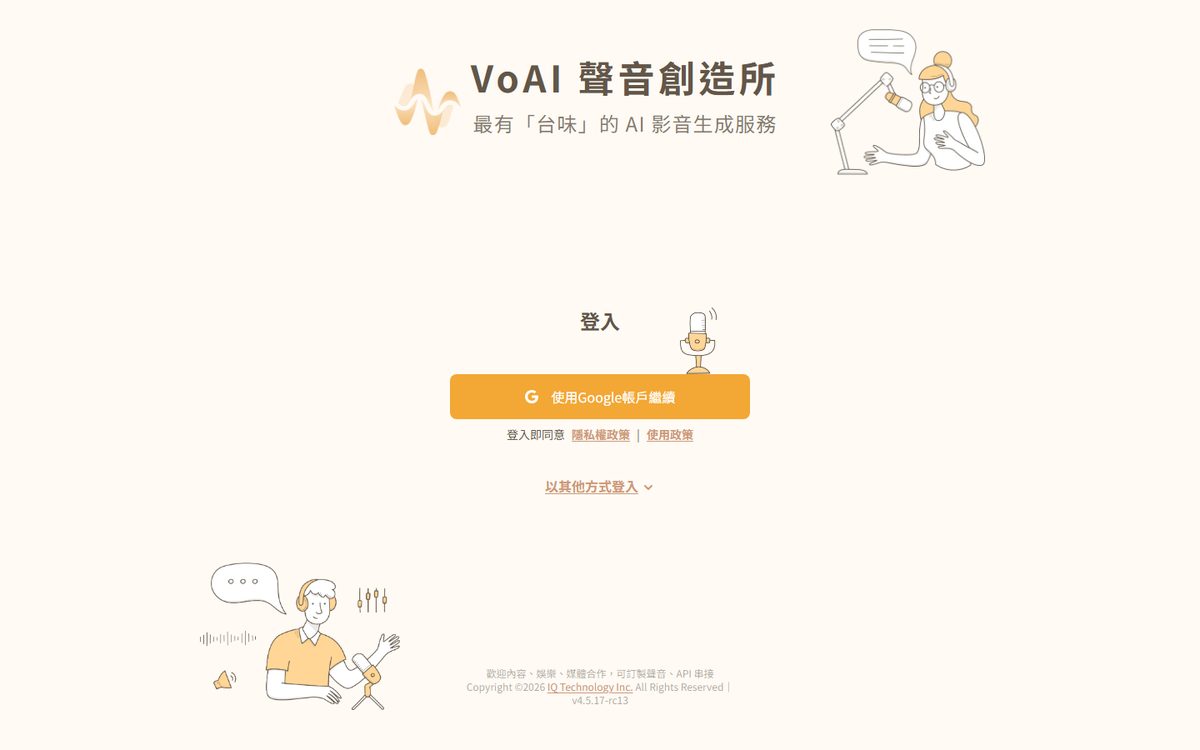
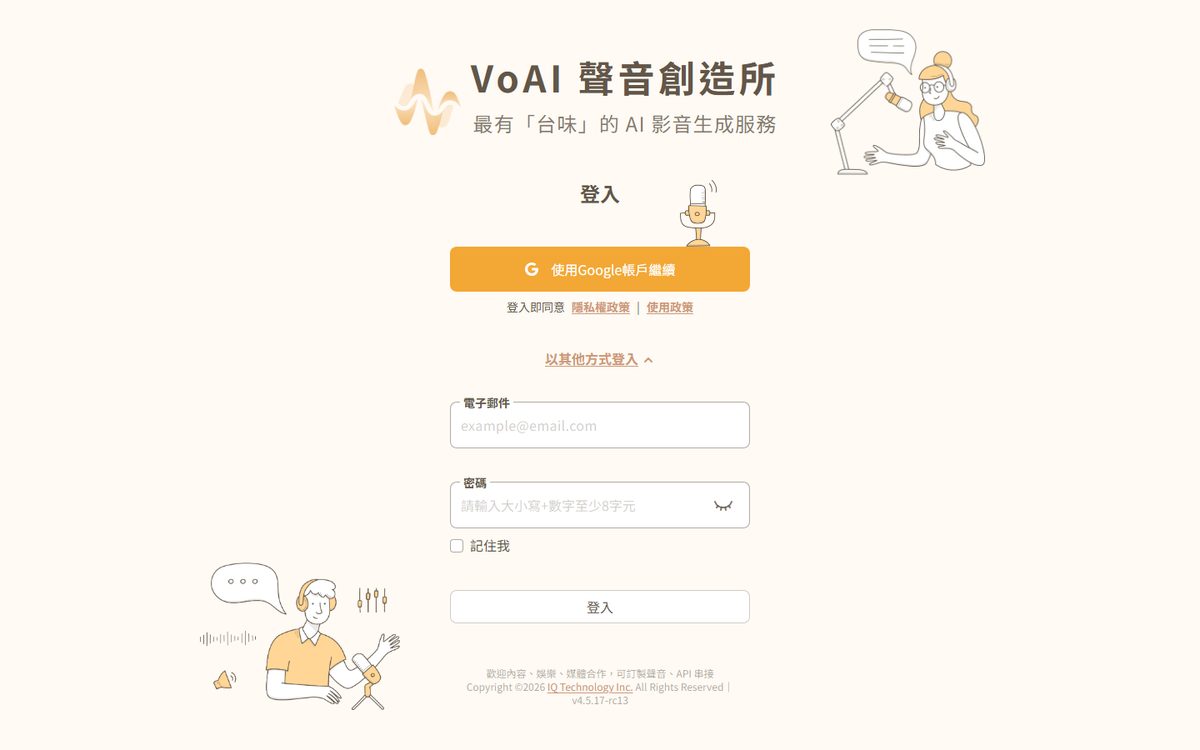
VoAI 提供 Google 一鍵登入,或以 Email + 密碼登入。登入即代表同意隱私權政策與使用政策。
- 使用 Google 帳戶登入點擊 使用Google帳戶繼續,以 Google 帳號快速登入。
- 以其他方式登入(Email + 密碼)點 以其他方式登入 展開 電子郵件 與 密碼 欄位,可勾選 記住我,再按 登入。
- 同意條款登入即同意 隱私權政策 與 使用政策。
介面導覽與會員管理 /setting
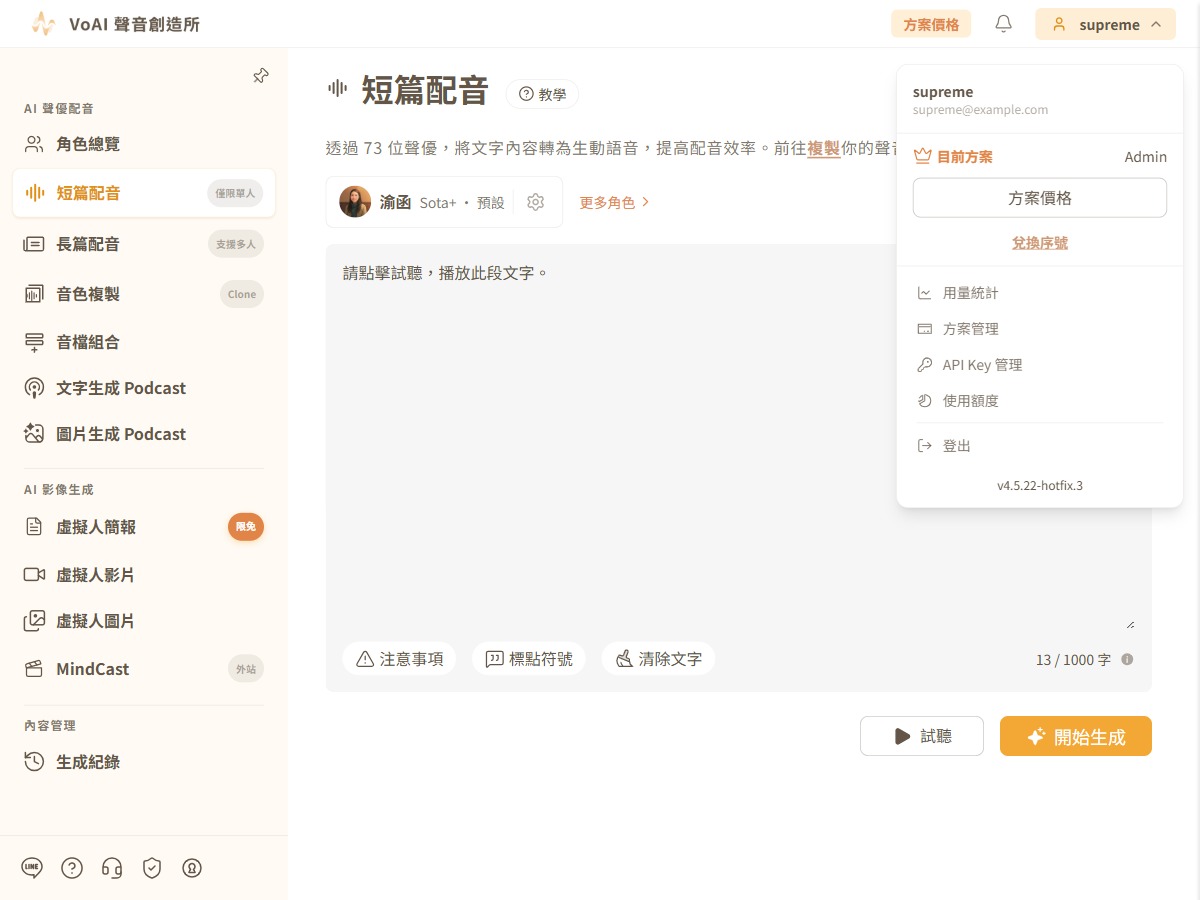
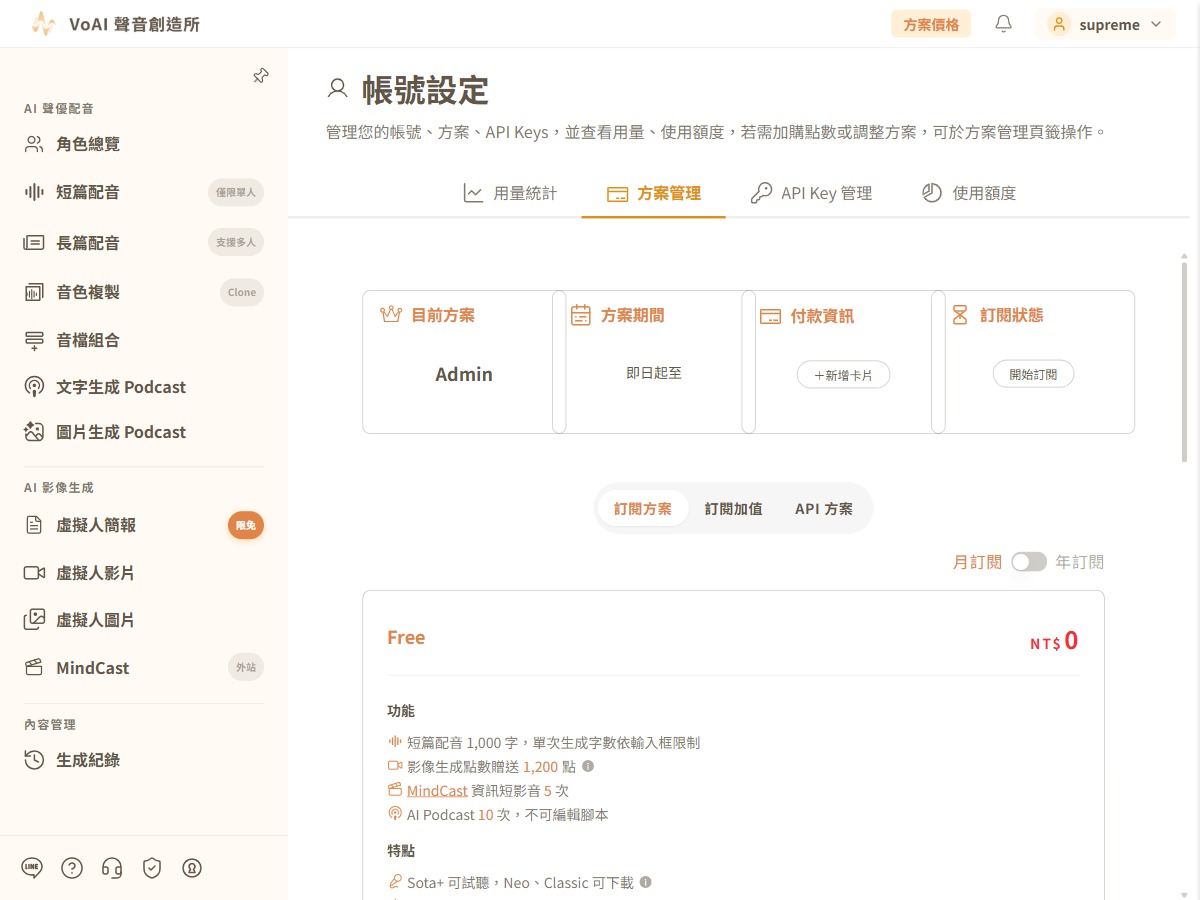
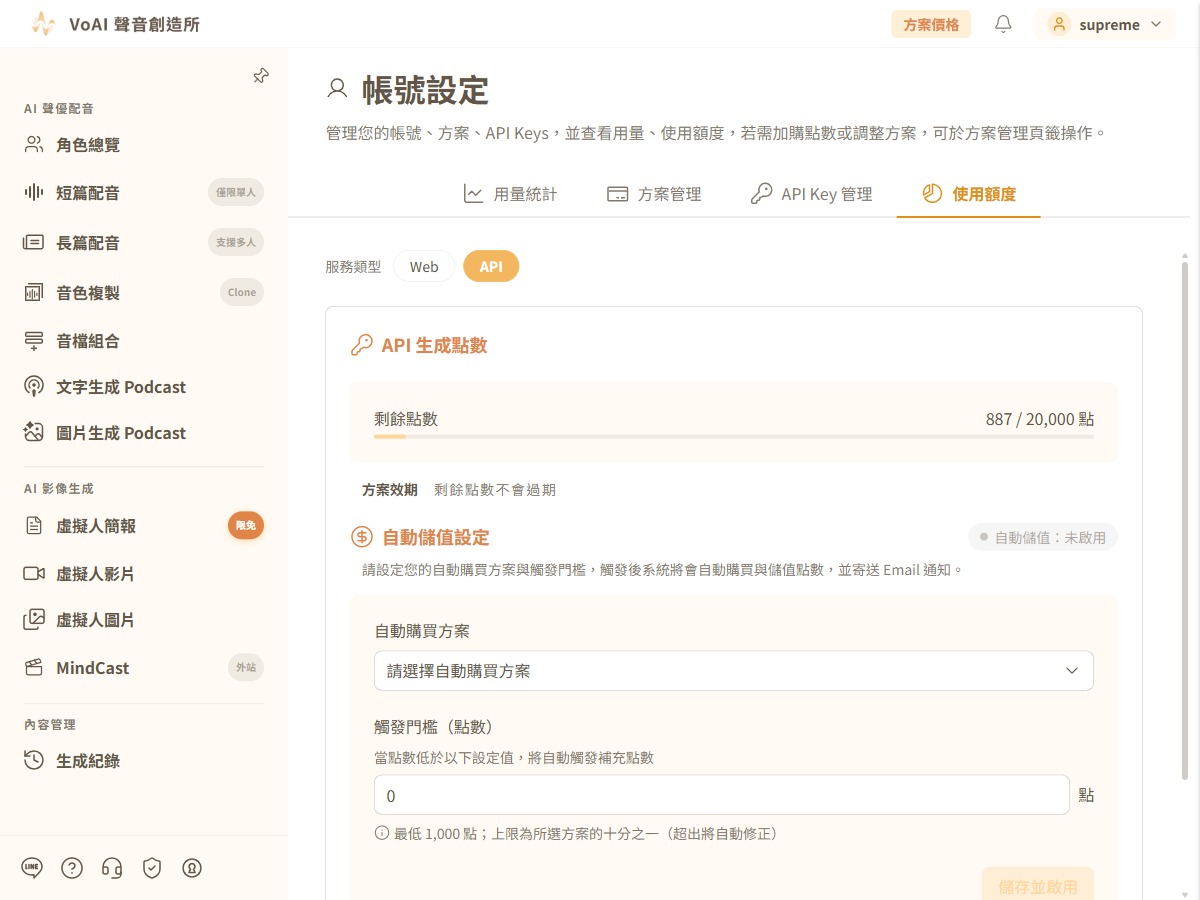
登入後左側是功能側邊欄,右上角是會員選單。帳號、方案、用量、額度都在「帳號設定」裡管理。
- 左側功能側邊欄依三大分組排列:AI 聲優配音(角色總覽、短篇配音、長篇配音、音色複製、音檔組合、文字/圖片生成 Podcast)、AI 影像生成(虛擬人簡報、虛擬人影片、虛擬人圖片、MindCast)、內容管理(生成紀錄)。部分項目帶標籤:短篇配音 僅限單人、長篇配音 支援多人、音色複製 Clone、虛擬人簡報 限免、MindCast 外站(另開網站)。
- 右上角會員選單點頭像展開:最上方顯示 目前方案 與 方案價格,其下為 用量統計、方案管理、API Key 管理、使用額度、登出;非付費用戶另會顯示 兌換序號 入口。
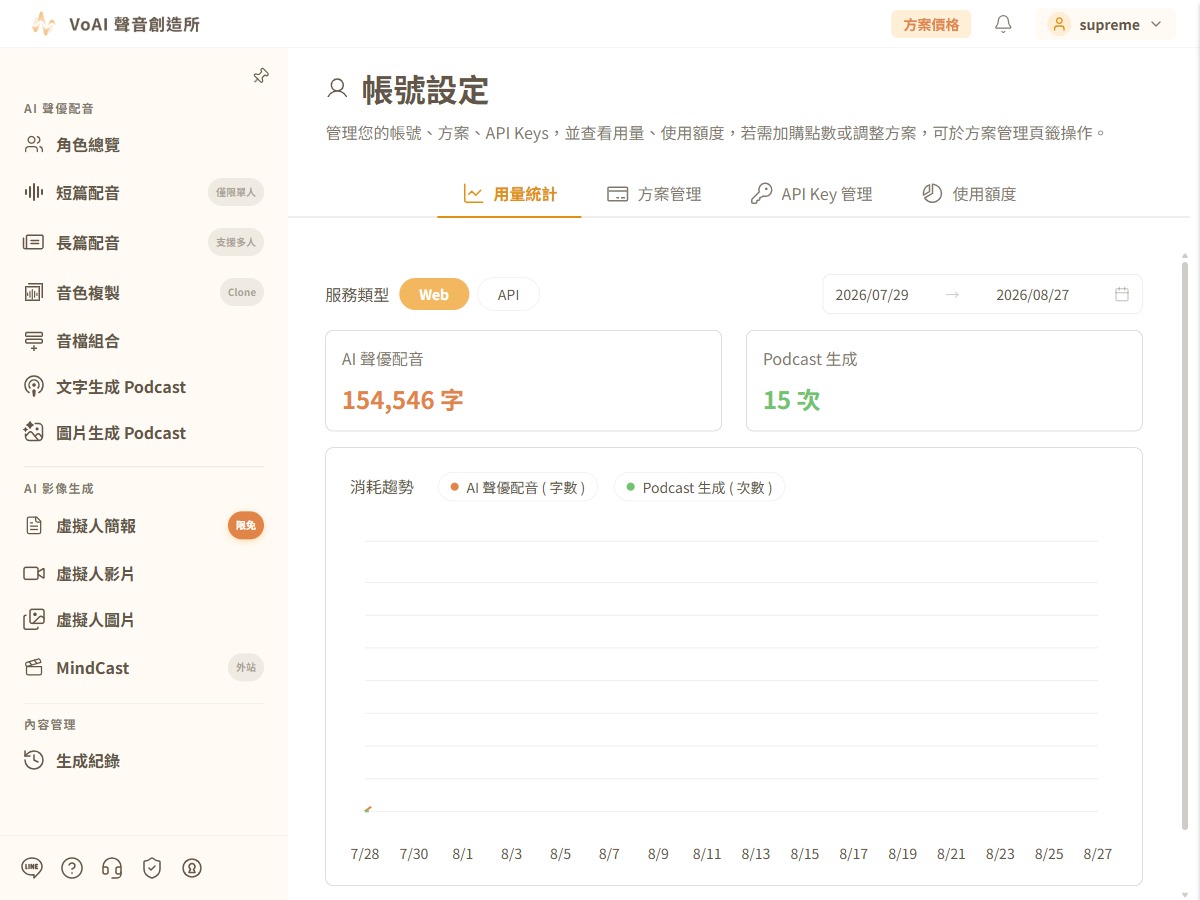
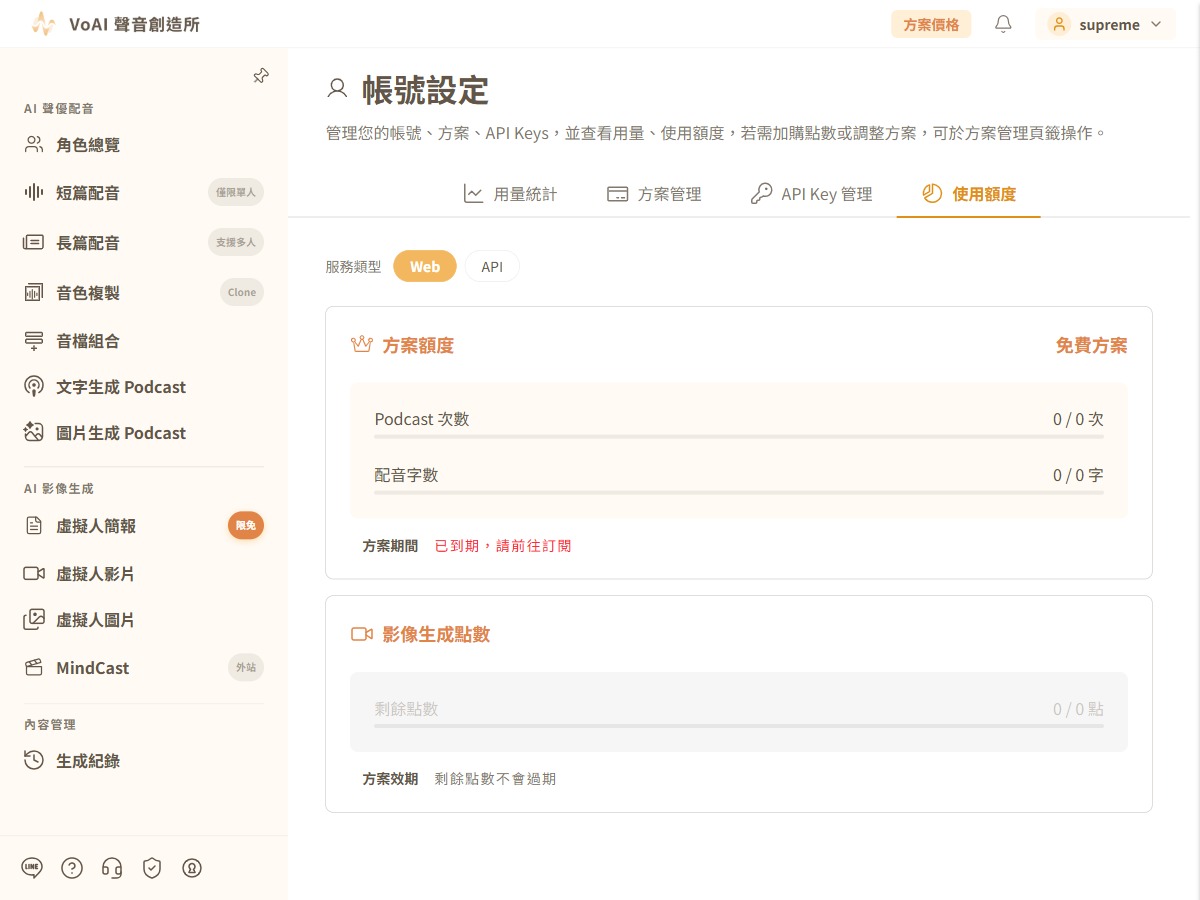
- 帳號設定四大分頁進入 帳號設定 後可切換:用量統計、方案管理、API Key 管理、使用額度。
- 切換服務類型(Web / API)用量統計 與 使用額度 都有 服務類型 切換:Web(在網站上生成)與 API(以 API Key 呼叫),預設為 Web。兩頁各自記住你上次看的服務類型、互不影響;切換後網址會跟著更新,可直接分享該畫面的連結,也能用瀏覽器 上一頁 回到切換前的服務類型。使用額度 的 方案額度、影像生成點數 在 Web;API 生成點數 與 自動儲值設定 只在 API。
- API 說明文件要以程式介接 VoAI,在 API Key 管理 建立金鑰後,可參考 API 說明文件。
- 升級方案 / 加值在 方案管理 或右上 方案價格 進入方案頁,比較 Free/Starter/Creator,完成訂閱或加值。
- 每個功能頁自己的成品入口各生成頁右上角都有 教學 與 生成紀錄/專案列表 入口,可直接查看該功能的成品,不必繞到「生成紀錄」頁(第 14 章)。
角色總覽 /actors
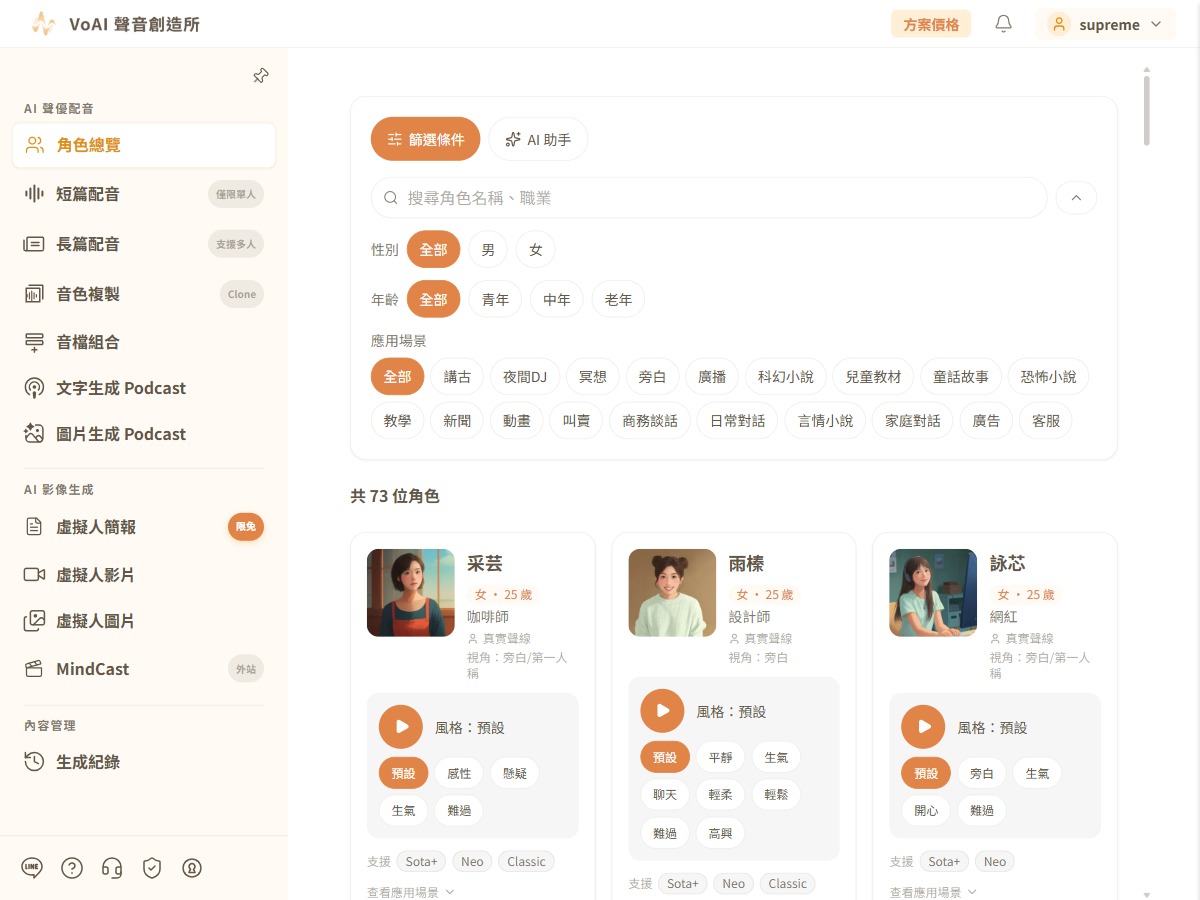
瀏覽 VoAI 全部 73 位 AI 聲優,用篩選或 AI 助手挑出最合適的聲音並試聽。
- 搜尋角色在搜尋框輸入:搜尋角色名稱、職業。
- 篩選條件依 性別、年齡(青年/中年/老年)、應用場景 過濾,可按 清除 重置。
- 改用 AI 助手切到 AI 助手,用自然語言描述需求(例:我想要一個溫暖的女性旁白)並 送出,讓小 V 推薦。
- 試聽與挑選在角色卡片 選擇風格 試聽,並可 查看應用場景。
短篇配音 /create
選一位聲優、輸入文字,即可將文字轉為生動語音。支援 Classic、Neo、Sota+ 三大模型。
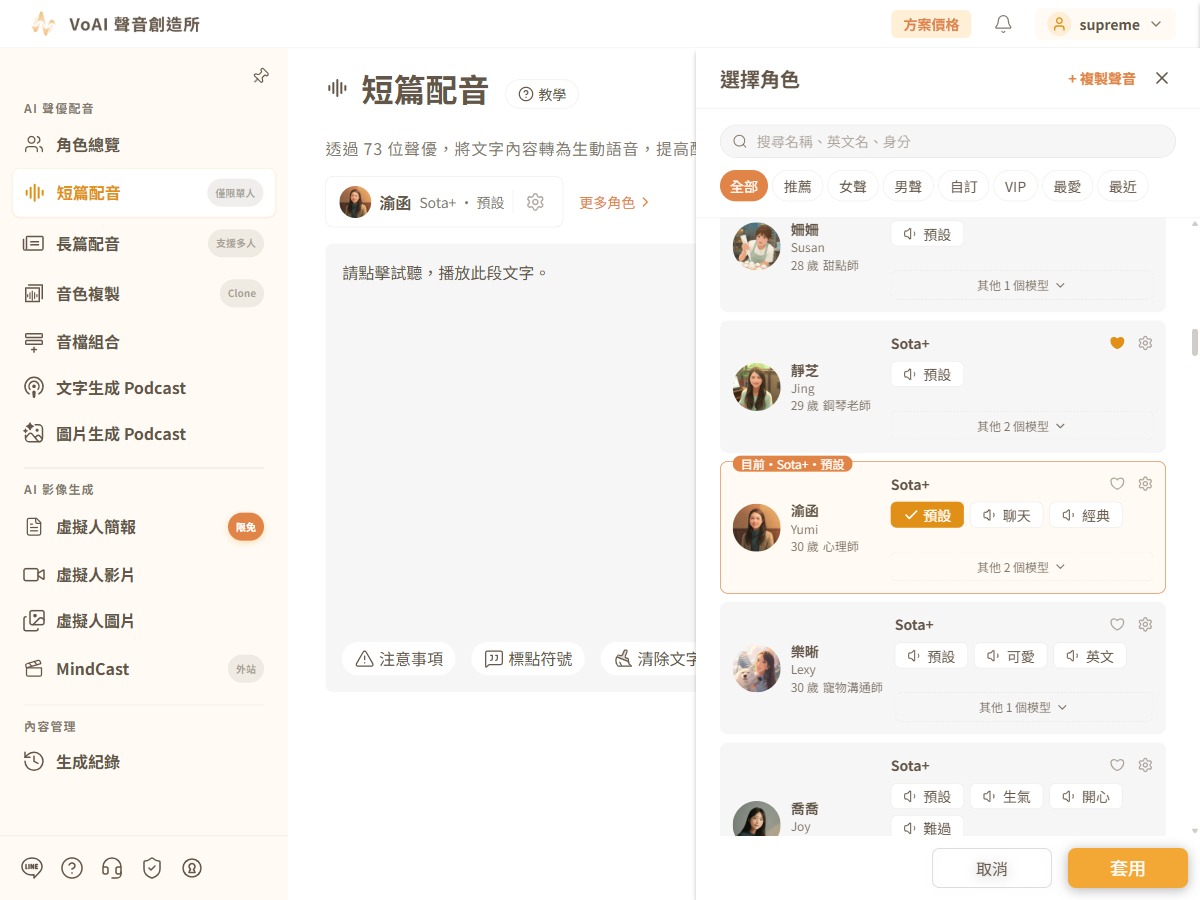
- 選擇角色點 更多角色 或角色列挑選聲優。面板上方可用 搜尋名稱、英文名、身分 搜尋,或用分類切換:全部、推薦、女聲、男聲、自訂、VIP、最愛、最近。
- 收藏常用角色點角色卡右上角的 愛心(在齒輪左邊)即加入 最愛(愛心轉實心紅色),再點一次取消。切到 最愛 分類只顯示收藏的角色,依收藏時間新到舊排列,分類上會顯示目前收藏數量;最愛裡是完整角色卡,可直接選模型與風格、試聽。在 最愛 分類內取消收藏時,卡片會暫留原位方便點回來,切換分類再回來才移除。此角色面板在 短篇配音、長篇配音、虛擬人簡報 通用。
- 輸入文字在文字框輸入內容,單次上限 1,000 字(右下角顯示目前字數),句尾務必加上標點符號(不支援注音、特殊符號與中英文以外語言)。文字框下方另有 注意事項、標點符號、清除文字 三個輔助按鈕。
- 選擇模型與進階設定點 模型比較 了解 Classic/Neo/Sota+(Sota+ 限 Creator 方案);齒輪 進階設定 可調音調、語速、句間停頓、風格權重。
- 試聽按 試聽 聆聽前 20 字音色(僅供參考,與實際結果可能略有不同)。
- 開始生成確認後按 開始生成,完成後可於下方播放與下載。
出現「超出流量上限」時
配音有每個整點的流量上限,短篇與長篇分開計算。畫面會提示可重試的台灣時間,等到該時間後回來即可繼續生成。
| Sota+最新 | Neo | Classic舊版 | |
|---|---|---|---|
| 適用場景 | 中英夾雜 / 旁白 | Podcast / 廣告台詞 | 長文 / 大量生成 |
| 特色 | 最新版本模型,語調自然,中英切換無斷層 | 語氣轉折流暢,適合長段口語化內容 | 穩定可靠、生成速度最快,適合批次處理 |
| 自然度 | ◯ 良好 | ◯ 良好 | △ 普通 |
| 英文流暢度 | ◯ 良好 | △ 普通 | △ 普通 |
| 生成精準度 | ◯ 良好 | △ 普通 | ◯ 良好 |
| 生成速度 | ◯ 良好 | ◯ 良好 | ◯ 良好 |
長篇配音 /longCreate
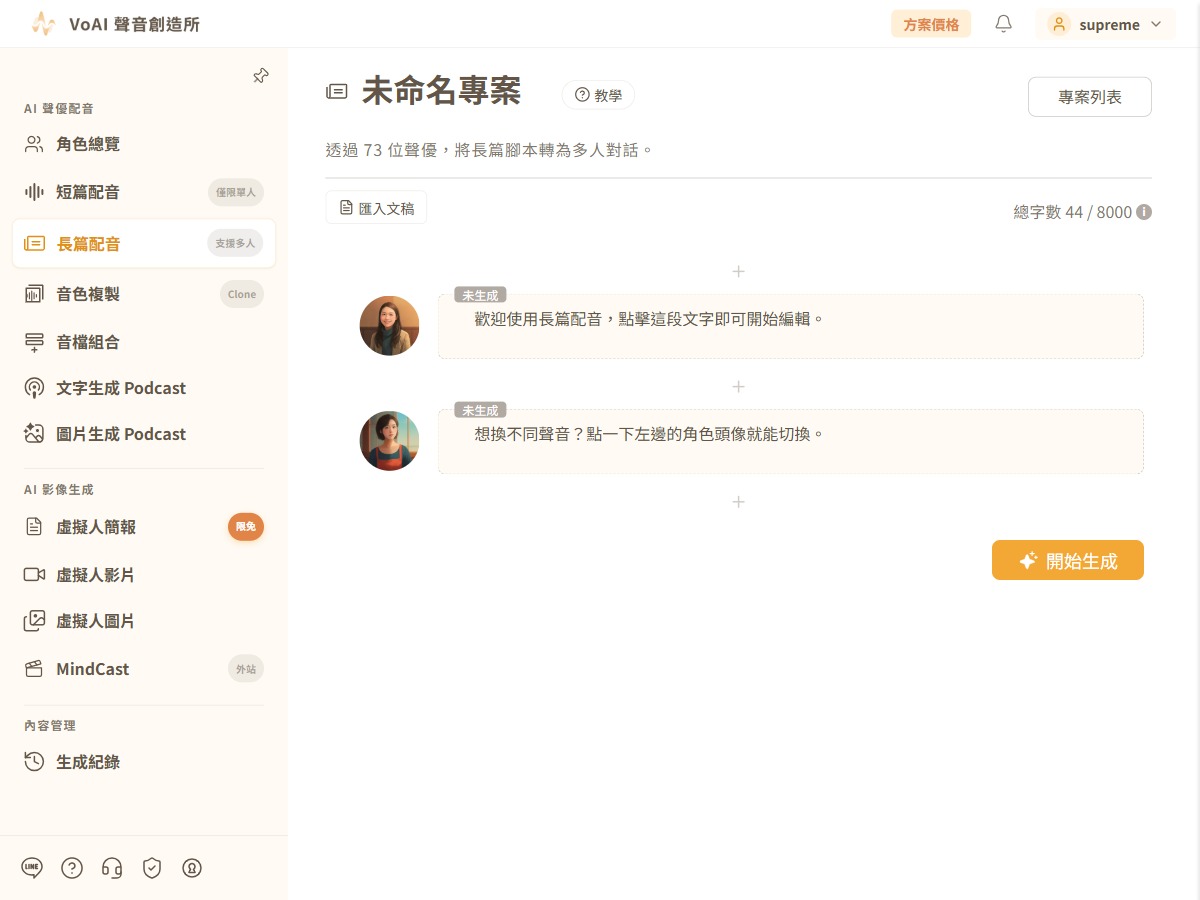
將長篇腳本轉為多段、多角色的對話配音,並可針對單一段落單獨重新生成。
- 建立 / 開啟專案從 專案列表 進入或新建專案;列表捲動到底會自動載入更多紀錄。
- 編輯段落內容點段落輸入文字(每段上限 500 字,整個專案總字數上限 8000 字)。可用 新增段落 增加段落、新增靜音 插入停頓(0.1~60 秒);或用 匯入文稿 貼上整段劇本,自動拆段並分配說話者(會開一個新專案)。
- 逐段指定角色點段落左側頭像開啟角色面板,選角色與風格後按 套用 切換聲音(變更角色)。
- 一次換掉同一角色的所有段落同一位角色用在 2 段以上時,角色面板底部會出現 一鍵套用 核取框(例:一次把「渝函」的所有段落換成「采芸」(共 5 段))。勾選後按套用即批次換角,不必逐段點。
- 開始生成按 開始生成 產出全部段落語音。
- 單一段落重新生成改完某段文字或角色後,將滑鼠移到該段落上,上方就會出現一排操作按鈕,單獨重跑該段即可,不必整篇重來。
音色複製 /voiceClone
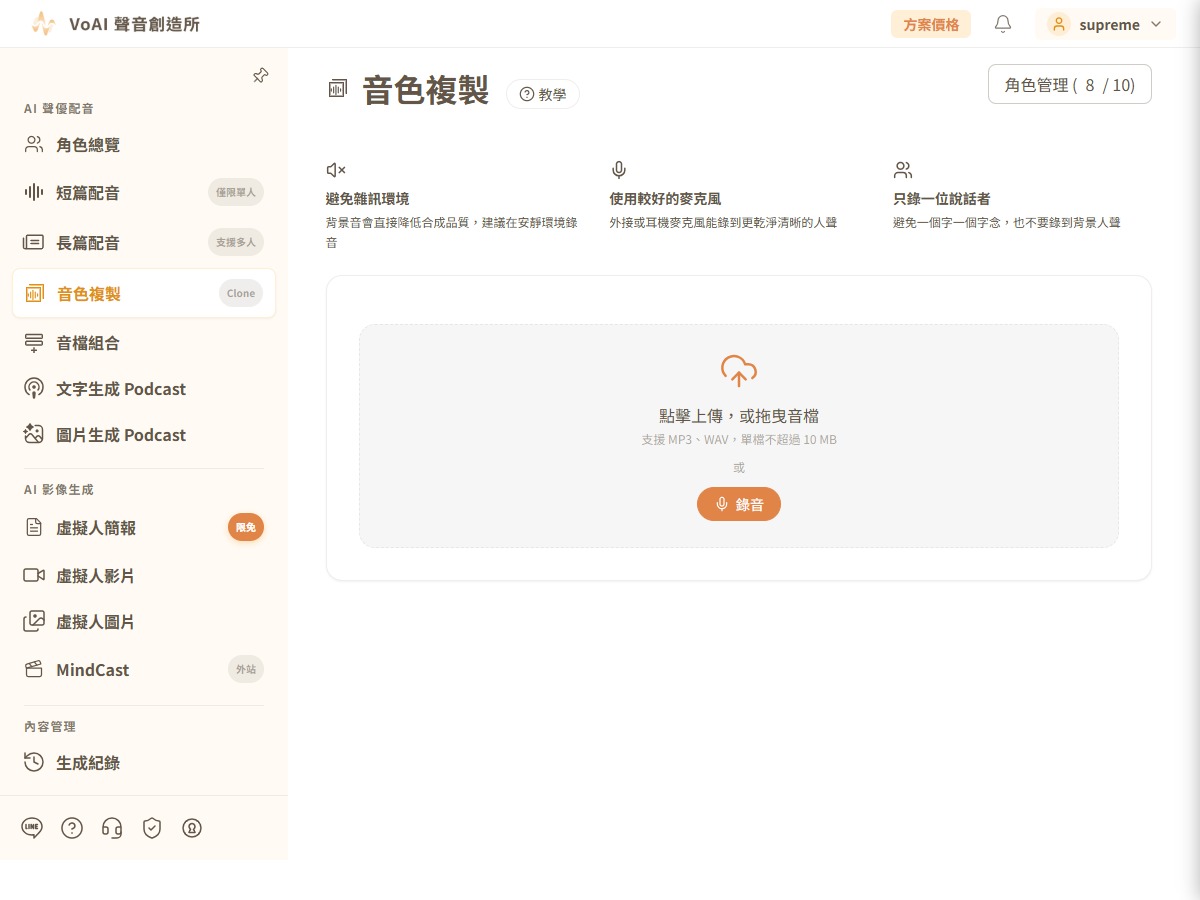
錄製或上傳一段音檔,複製你的音色成專屬角色,後續即可用來配音。
- 選擇音源點擊錄音 或 上傳音檔(MP3、WAV,10 MB 以內)。
- 錄音(若選錄音)可參考文案朗讀(內容不需完全一致),選風格後 開始錄音,也能 換一句。
- 裁切波形在 確認頭尾靜音時長 選取採用片段(前後各留約 0.3 秒靜音),按 下一步:生成試聽。
- 試聽與比對於 試聽生成結果 對照文稿聆聽,系統會做品質比對(比對通過/欠佳/無法比對)。
- 命名並儲存填 角色名稱(上限 10 字,不可與既有音色同名)、勾選權利聲明後按 儲存音色。儲存自訂音色需 Creator 方案,每個帳號最多保存 10 個音色。
文字生成 Podcast /podcast
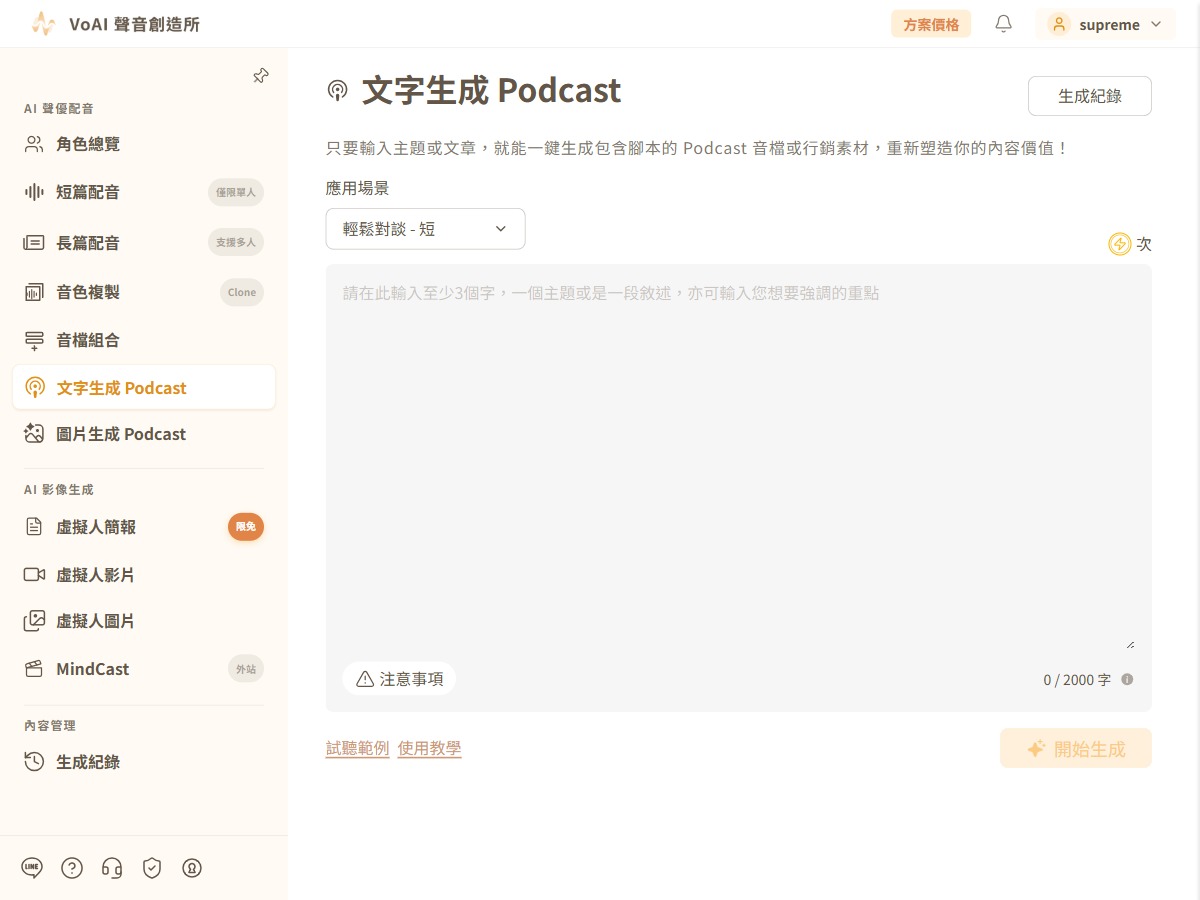
只要輸入主題、文章或網址,就能一鍵生成包含腳本的多人對話 Podcast 音檔或行銷素材。
- 選擇應用場景於 應用場景 選類別與對話類型(輕鬆對談、廣告行銷、兒童故事…)。
- 輸入主題內容輸入至少 3 個字、上限 2,000 字:一個主題、一段敘述,或是網址。
- 試聽範例(可選)可先 試聽範例 感受效果。
- 開始生成按 開始生成,產生對話腳本與音檔。
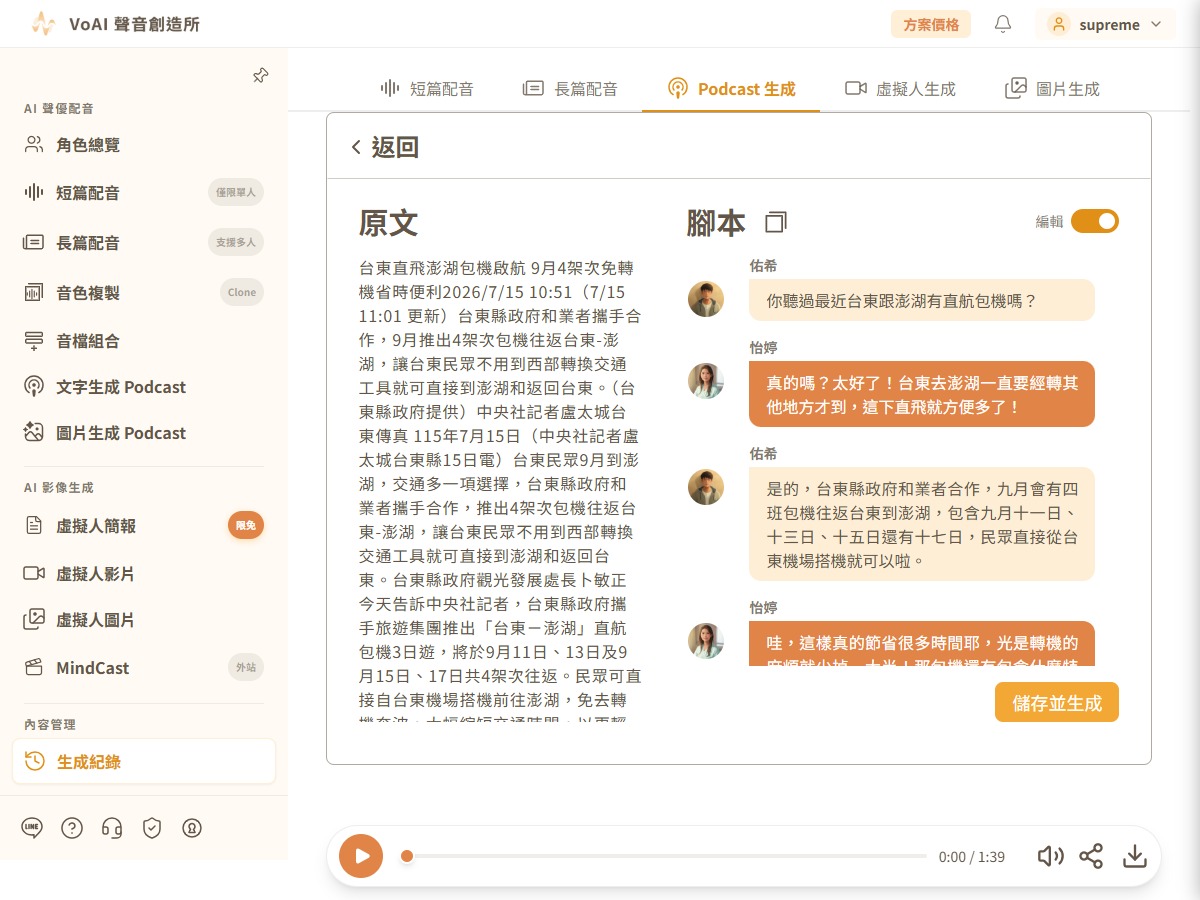
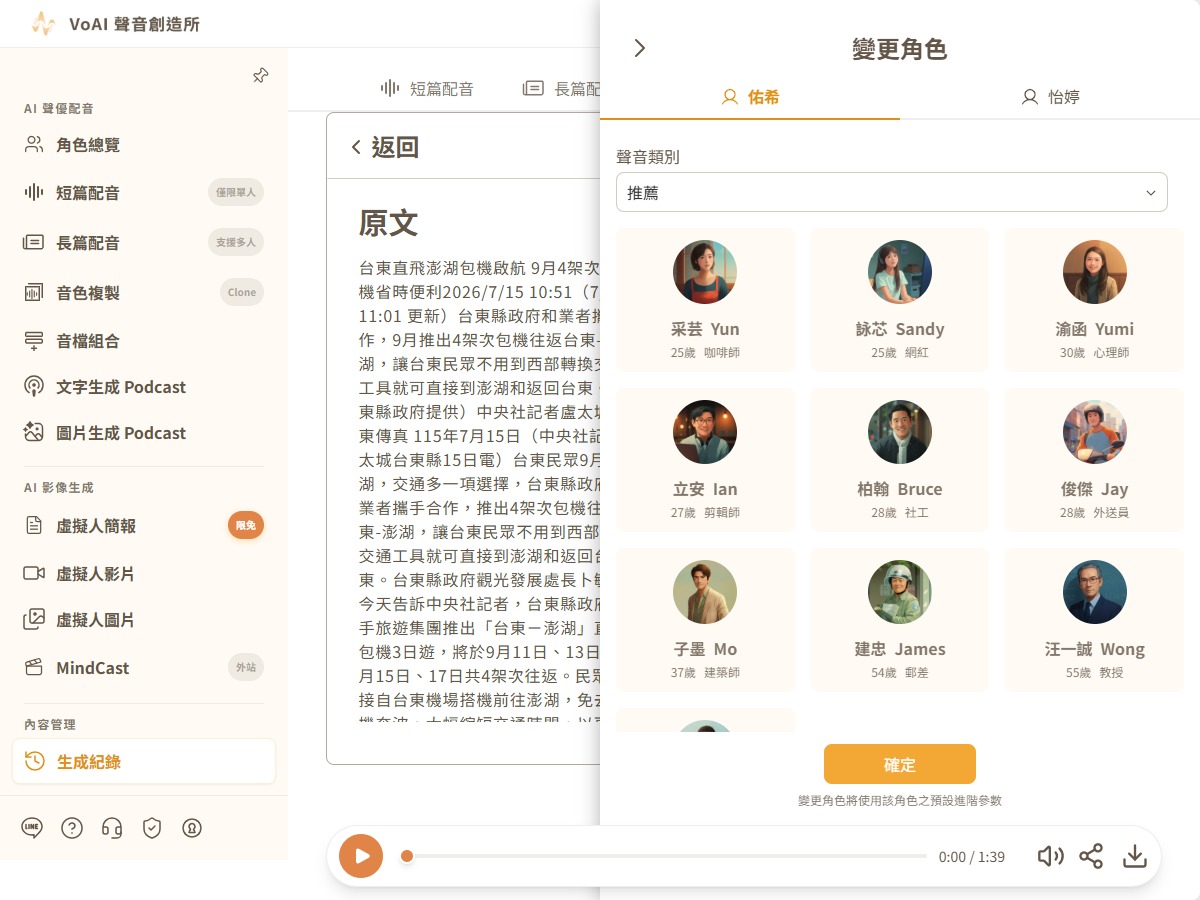
- 編輯腳本與換聲音點 腳本 開啟腳本,可 編輯對話內容、逐句 變更角色 換不同聲音,調整後再按 儲存並生成(此為付費用戶功能;於此頁面編輯腳本重新生成免扣額度)。
編輯腳本前先打開「編輯」開關
開啟腳本後,先把右上角的 編輯 開關打開,才能修改對話內容;改完點 儲存並生成 重新生成。
圖片生成 Podcast /photoPodcast
上傳產品圖片,自動辨識內容,一鍵把靜態圖片轉成有故事的行銷 Podcast。
- 選擇應用場景於 應用場景 選擇類別。
- 上傳圖片拖曳圖片或瀏覽檔案上傳(JPG / PNG,10 MB 以內,一次一張)。
- 自動辨識文字可開啟 文字精準辨識,系統辨識圖片內容(顯示「正在辨識圖片…」)。
- 開始生成補充或修改辨識文字後,按 開始生成,產生對話腳本與音檔。
- 編輯腳本與換聲音點 腳本 開啟後,打開右上角 編輯 開關即可 編輯對話內容、點說話者頭像 變更角色 換聲音,調整後 儲存並生成(編輯介面與文字生成 Podcast 相同,見第 7 章示意)。
音檔組合 /audioComposer
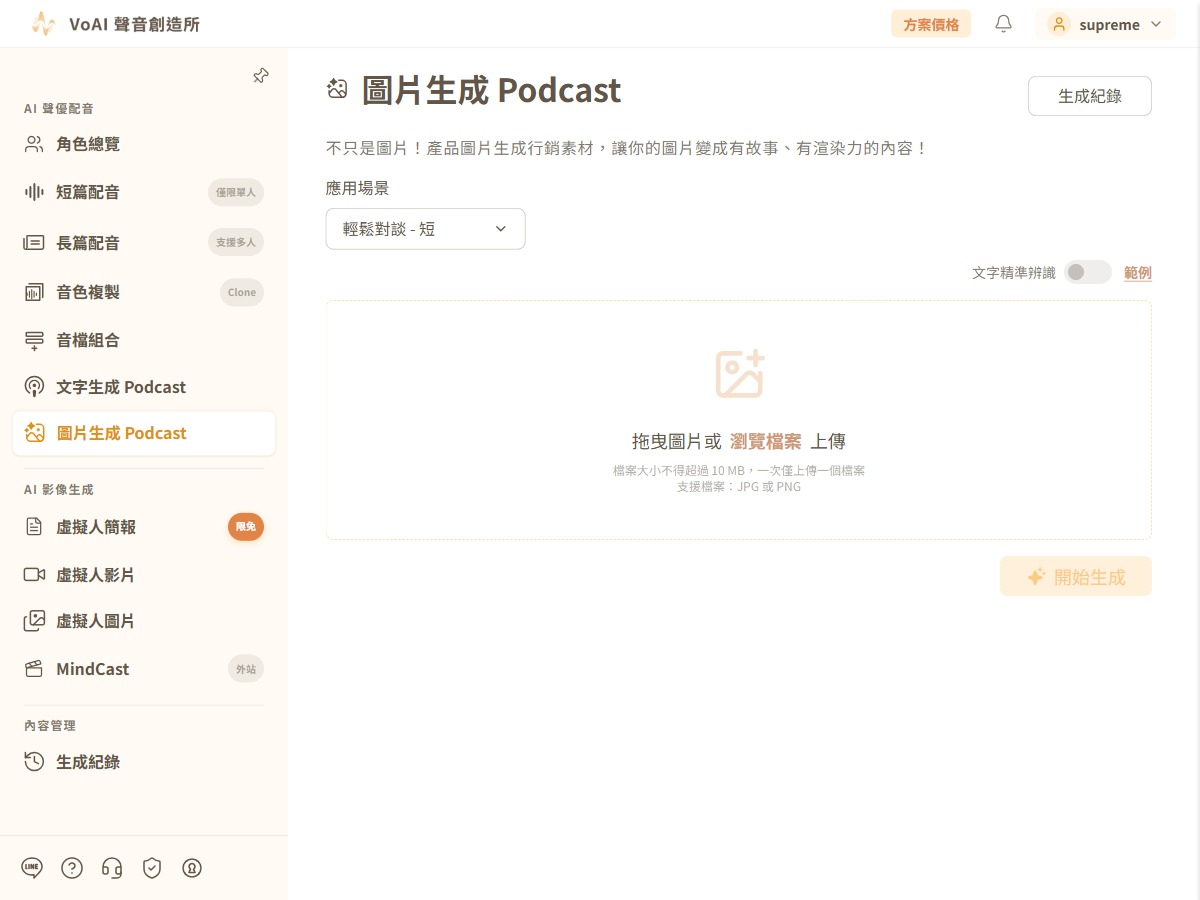
上傳多段音檔(含片頭片尾),拖曳排序、插入靜音,快速組合成完整內容。(需訂閱方案)
- 加入音檔按 + 加入音檔(可多選) 上傳,最多 40 段、每檔 15 MB。
- 調整順序拖曳音檔卡片調整播放順序。
- 插入靜音於音檔間 新增靜音 並設定秒數。
- 組合輸出按 組合音檔 生成完整音檔(支援 wav、mp3)。
虛擬人簡報 /pdfToVideo
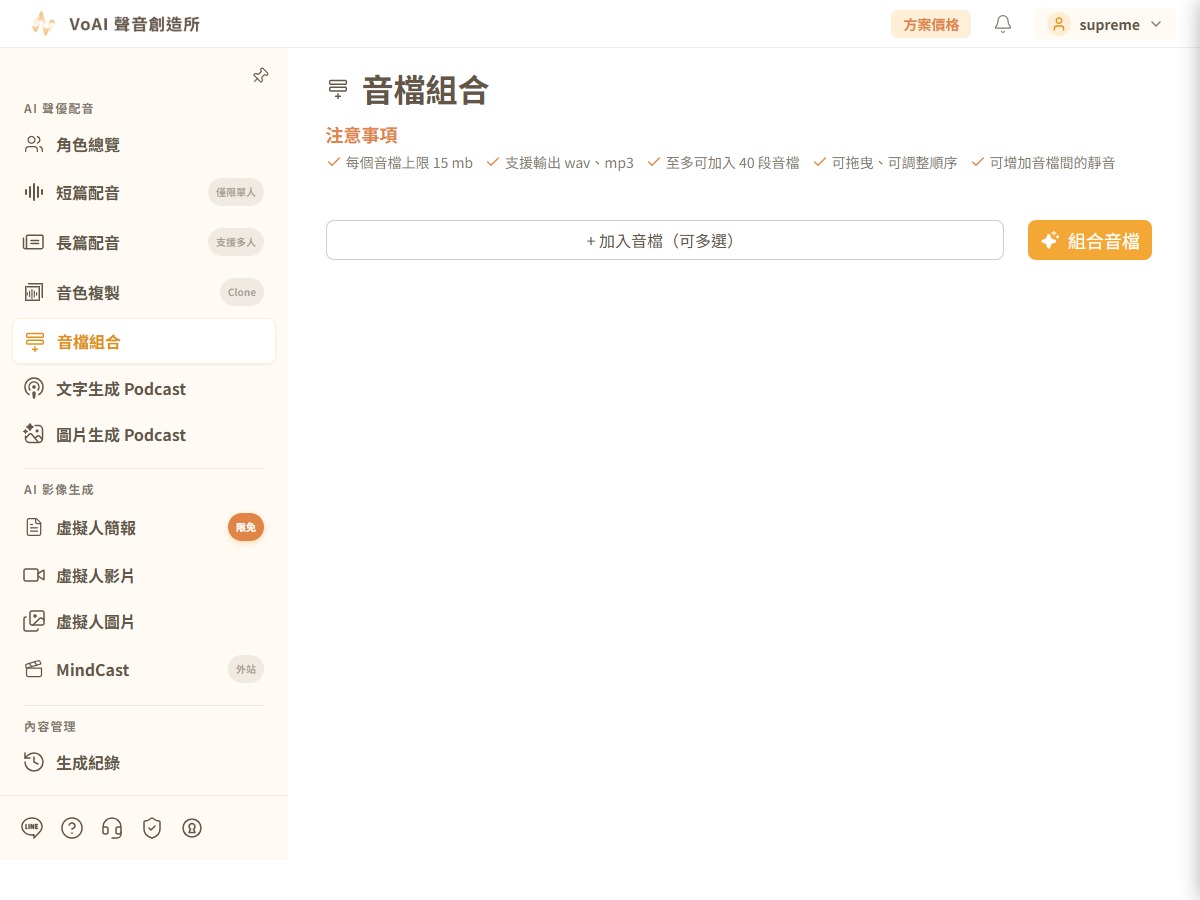
上傳簡報 PDF,AI 自動為每頁寫講稿並生成虛擬人解說影片,再合併為完整成片。(1 秒 = 2 點,目前 限時免扣點)
- 上傳 PDF首次進入先按 開始建立影片,於 上傳簡報 PDF 視窗 拖放 PDF 到此區域 或點擊選擇檔案(最多 20 頁、30 MB)。上傳後 AI 會分析投影片並逐頁生成講稿。
- 選擇角色頭像與聲音於底部設定 角色頭像(選範本或 上傳照片,半身照尤佳、不可遮擋五官)與 角色聲音。
- 確認逐頁文稿確認或修改各頁文稿(輸入此頁要朗讀的文稿,每頁上限 500 字),每頁可選 AI 生成 或 靜音(靜音 1–60 秒,常用於轉場頁、章節間隔頁)。文稿改過後會提示「下次『開始生成』會自動重生此頁音檔」。
- 整份文稿一次貼上(可選)按 匯入文稿,以 P1:、P2: 標記分頁貼上,遇到下一個標記才換頁、對應不到的頁碼會自動跳過。匯入會覆蓋對應頁現有文稿並重置音/影狀態。
- 決定字幕與版面底部兩個開關:字幕(預設開,切換即時生效、不需重新生成)、PDF 滿版(預設關;切換後已生成的頁會失效,底部退回「開始生成」需重跑)。
- 生成與下載按 開始生成,完成後從 下載專案 取得 下載影片 - 無字幕/下載影片 - 含字幕/下載字幕 - srt 檔。
- 傳錯檔就重新上傳工作區右上角的 重新上傳 PDF 可換一份簡報,主按鈕為 覆蓋並上傳(生成進行中會停用)。
編輯文稿與匯入文稿為付費功能
免費方案的文稿欄位為唯讀(顯示「升級付費方案後可編輯文稿」),升級任一付費方案後即可自由編輯每頁文稿、一次匯入整份文稿。
本功能的「專案列表」尚在開發中
右上角的 專案列表(開發中) 目前不可點擊。請於工作區內完成下載,離開前先把成片與字幕存下來。
虛擬人影片 /avatar
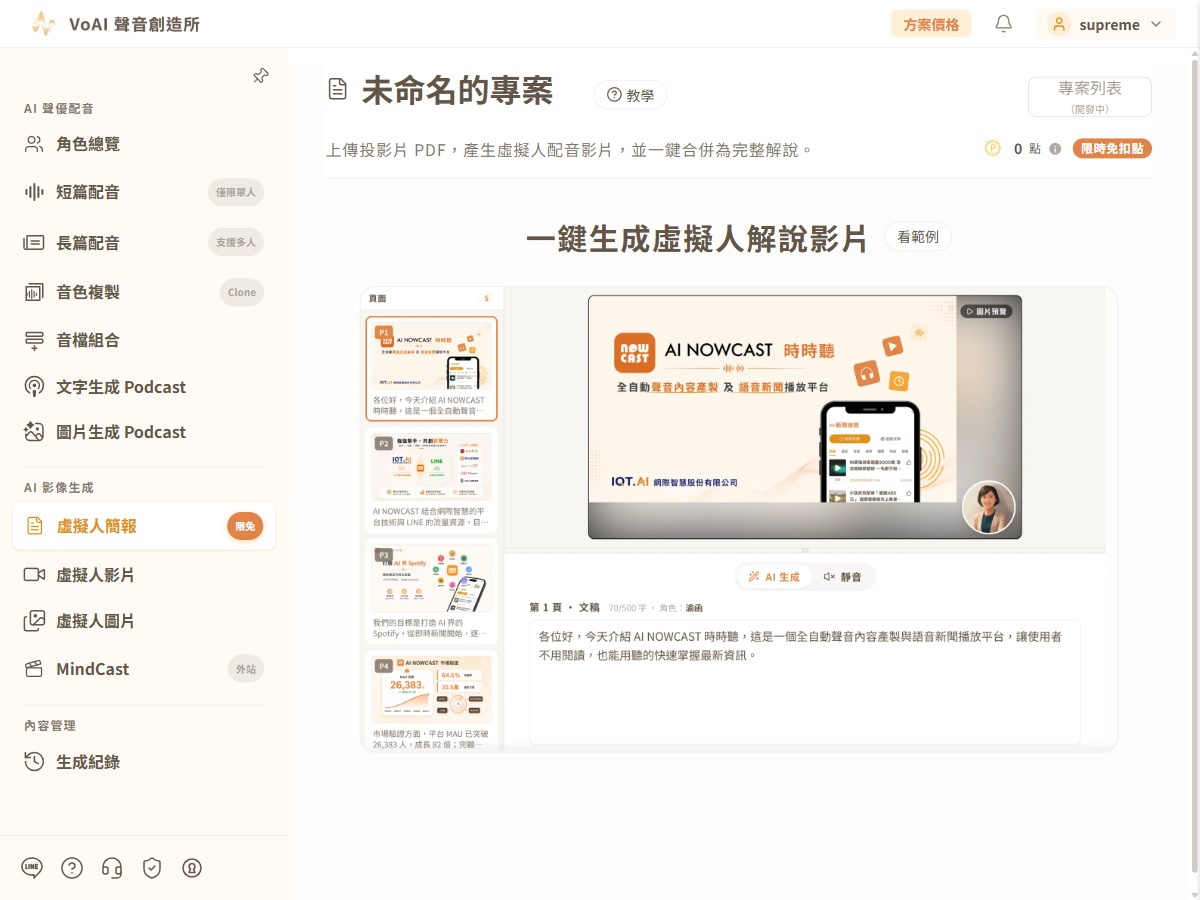
用一張人像加一段語音,讓虛擬分身開口說話。分鏡可各自獨立生成,成品可下載高畫質。(1 秒 = 10 點)
- 選擇影片比例直式 9:16、橫式 16:9 或 正方形 1:1。
- 上傳圖片素材選擇範本/上傳檔案/即時拍照(支援 JPG、PNG),可 編輯裁切 與預覽放大。使用他人肖像須自行取得授權。
- 準備音檔AI 生成/上傳檔案/即時錄音(長度 5~120 秒,支援 WAV、MP3、M4A)。單次生成的圖片與音檔合計不得超過 30 MB。
- 用 AI 生成語音(可選)在音檔來源選 AI 生成,填 語音生成文字稿 並選角色後按 生成音檔(Sota+ 模型僅限 Creator 方案)。同一片段再次生成時,會自動帶回當初用的文字稿與角色,不用重打。
- 管理分鏡片段在「分鏡片段」面板 加入下一段、拖曳排序、刪除片段;各段可獨立生成(狀態:生成中/生成成功/生成失敗),面板會顯示 總時長。
- 確認消耗點數後開始生成按開始生成後會出現 影片產出時間 提示,載明本次將消耗的點數,按 繼續生成 即開始;可勾選 完成時 Email 通知,生成期間可離開去做別的事,於專案列表查看進度。
- 單一分鏡重新生成可 重選圖片/重選音檔 換素材;有失敗片段時,面板下方按鈕顯示 重新生成。失敗片段會提示「此片段生成時發生問題,請點擊重新生成再試一次」。
- 下載影片(可選畫質)下載選單提供 下載影片 - 原始 與 下載影片 - 高畫質(1080P)。
高畫質下載(1080P)
下載高畫質影片需等待較久時間,期間可進行其他操作,下載完畢將會收到通知。
專案保留期限,請及早下載
虛擬人專案自建立後保留 14 天;訂閱後新建立的專案可保留 1 年。專案列表上方也會顯示這項提醒,請於到期前下載成品。
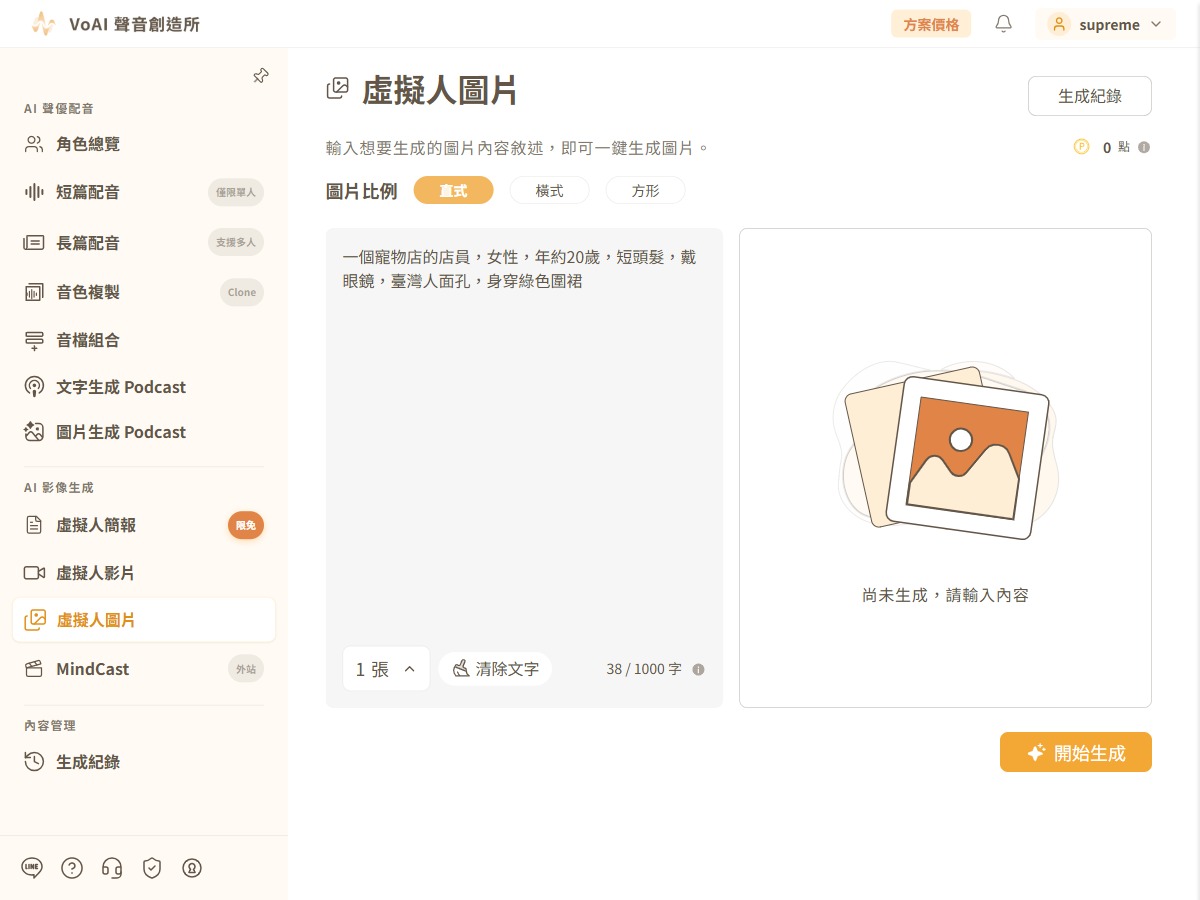
虛擬人圖片 /textToImage
輸入圖片內容敘述,AI 生成符合描述的圖片。(1 張 = 5 點)
- 選擇圖片比例方形/直式/橫式。
- 輸入描述在文字框 詳細描述想要生成的圖片內容...(上限 1000 字)。
- 設定數量選擇一次生成張數(1~2)。
- 開始生成按 開始生成。點數不足時可前往 去訂閱 或 去加值。
- 放大檢視與下載生成後點圖片可 放大預覽,一次多張時用 上一張/下一張 切換,再按 下載圖片 存檔。
生成後操作
音檔或影片生成完成後,可在結果區或生成紀錄中進行下列操作。
影片成品另有畫質選項
虛擬人影片可另選 下載影片 - 原始 或 下載影片 - 高畫質(1080P),詳見第 11 章。
生成紀錄 /history
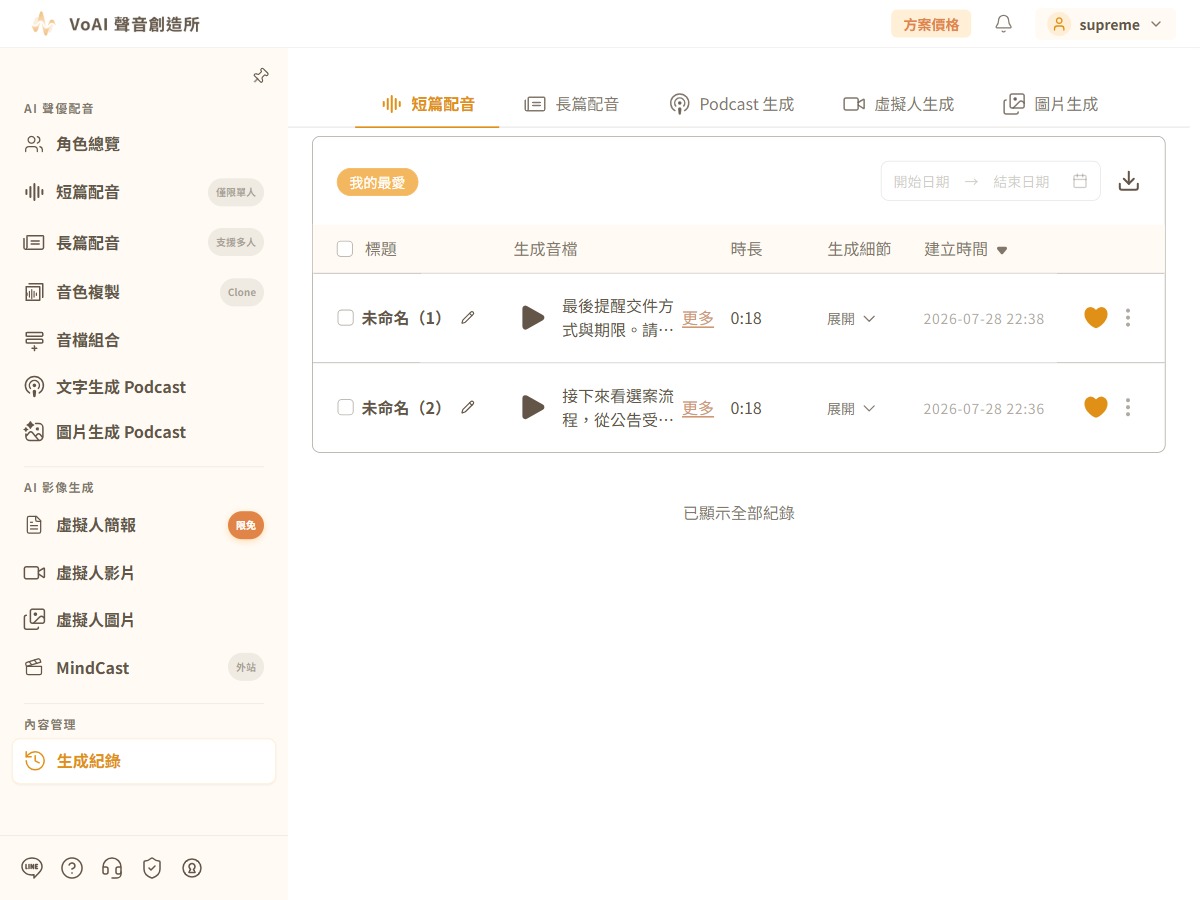
所有生成成品都會保存在「生成紀錄」,依類型分頁管理;各功能頁右上角也有各自的入口。
- 依類型切換分頁短篇配音、長篇配音、Podcast 生成、虛擬人生成、圖片生成。其中 長篇配音 分頁直接內嵌長篇的專案列表,與長篇配音頁的「專案列表」是同一份內容。
- 篩選與搜尋可用 我的最愛 與 開始日期/結束日期 篩選(Podcast 生成 分頁另有 客製模板);短篇配音 與 Podcast 生成 分頁右側的下載圖示可 下載全部,匯出該分頁的紀錄清單(Excel)。
- 捲到底自動載入清單底部不再有分頁用的「更多」按鈕,改為捲動到底自動載入下一批,全部載完會顯示 已顯示全部紀錄。(每列文稿旁的 更多 是展開全文,兩者不同。)
- 逐筆操作每筆紀錄可播放、展開檢視生成細節(原文、音調、語速、句間停頓、字數、建立時間),或從 更多選項 進行 分享音檔、下載檔案、字幕檔、重新命名,也可加入最愛或刪除。